Я совершил каждую тупую ошибку в Spark минимум по разу. На продовом масштабе — настоящие данные, настоящая конкурентность, настоящие стейкхолдеры, орущие в Slack — «работает» и «работает хорошо» это два совершенно разных разговора. Так что я начал их записывать.
Это чеклист, который я хотел бы иметь приклеенным к монитору, когда начинал. Каждый пункт вырос из реального продового провала — моего или чужого.
До того, как напишешь первую строку
- Используй DataFrame / Dataset API, а не RDD. RDD управляются лямбдами — Spark не видит, что внутри, и не может их оптимизировать. DataFrame проходят через оптимизатор Catalyst. Ты бесплатно получаешь pushdown предикатов, переупорядочивание фильтров, Adaptive Query Execution и переупорядочивание джойнов по стоимости. RDD API в MLlib в режиме поддержки. Отпусти.
- Выбери правильный формат файлов. Parquet для аналитических запросов — отсечение колонок, pushdown предикатов и пропуск по статистике работают из коробки. Avro для ингеста с активной эволюцией схемы. Для всего, что читается больше одного раза за неделю, положи сверху табличный формат — Iceberg или Delta — и получишь ACID, time travel и статистику, которой планировщик реально сможет пользоваться. Если читаешь сырой CSV или JSON, всегда задавай схему явно. Вывод типов означает полный скан ради того, чтобы понять типы.
- Используй splittable-сжатие. Snappy, LZ4 или ZSTD — только не GZIP. Файл GZIP на 10 ГБ нельзя разделить между экзекьюторами: одна несчастная нода распаковывает его целиком. Snappy — надёжный дефолт. ZSTD жмёт сильнее и, начиная со Spark 4.x, работает для шафла параллельно (SPARK-46256) — используй его для спиллов шафла и промежуточных файлов, чтобы срезать время на сети.
- Знай свою версию Spark. Spark 4.0 выбросил Scala 2.12, JDK 8, JDK 11, Mesos и Python 3.8. Если твоя платформенная команда всё ещё на чём-то из этого — вот первая битва, которую стоит выбрать: дальше чеклист исходит из того, что ты на JDK 17, Scala 2.13 и Python 3.9+. Не тюнингуй джобу на платформе, которая уже на поколение позади.
Партиционирование — скрытая архитектура
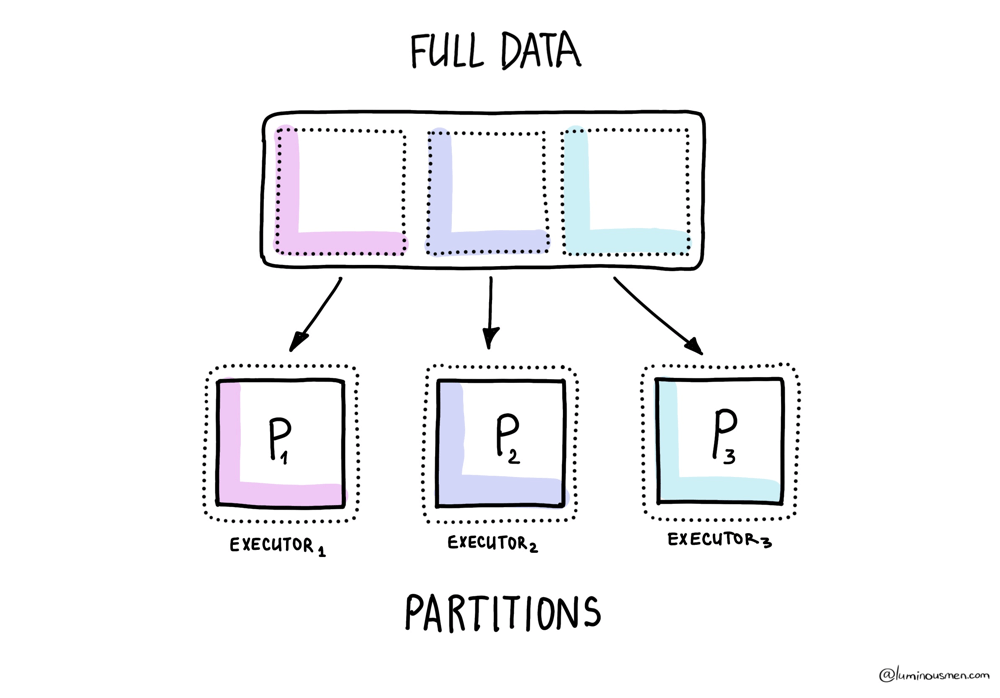
Полный разбор партиций Spark — как Spark вообще решает, сколько будет партиций, и все ручки, которые это меняют.
- Настрой
spark.sql.files.maxPartitionBytesпод свою раскладку хранения. Дефолт — 128 МБ. Если твои Parquet-файлы в основном 256 МБ и больше, ты недопараллелишь чтение. Если они по 8 МБ — у тебя слишком много тасок. Подгоняй размер сплита под реальное распределение файлов, а не под дефолт Spark. Это ручка со стороны входа — она задаёт стартовое число партиций до того, как включится схлопывание AQE. - Целься в 2–4 партиции на доступное ядро. Меньше — ядра простаивают. Больше — планировщик тратит на учёт тасок больше времени, чем на их выполнение. Если таски регулярно завершаются быстрее 100 мс, партиции слишком мелкие. Если одна таска идёт в 10 раз дольше остальных — у тебя перекос, см. раздел про джойны.
- Фильтруй рано, фильтруй жёстко. Двигай фильтры как можно ближе к источнику. Отсечение партиций существует не просто так: если данные партиционированы по дате и тебе нужна только последняя неделя, Spark не должен трогать остальные 51. С Dynamic Partition Pruning (включён по умолчанию в 4.x) это работает ещё и в рантайме через джойны. Что подводит меня к следующему пункту.
- [4.x] Используй многоключевой Dynamic Partition Pruning для составных партиций. SPARK-46946 добавил многоключевой DPP. Если факт-таблица партиционирована по (date, region) и ты джойнишь её с маленьким отфильтрованным dim, Spark теперь отсекает по обоим ключам в рантайме. Это открывает реальную производительность звёздной схемы, невозможную в 3.x. Конфиг не нужен — просто работает, если сторона dim уходит в броадкаст.
- Делай coalesce после тяжёлой фильтрации. Ты только что отфильтровал 2 миллиарда строк до 2 миллионов, а партиций всё ещё 10 000. Это 10 000 почти пустых тасок.
.coalesce()чинит это без полного шафла..repartition()— если нужно равномерное распределение по новому числу партиций. AQE-шный coalescePartitions сам схлопывает выход шафла, но со стороны входа после фильтра не поможет. - Репартиционируй по ключам джойна перед серией джойнов. Если ты трижды джойнишь один и тот же DataFrame по user_id, сделай repartition по user_id один раз и закэшируй. Иначе ты шафлишь одни и те же данные три раза. Лучше: если таблица долгоживущая, забакетируй её — см. раздел про джойны.
- Репартиционируй после
flatMap. flatMap может увеличить число строк в 10 раз, не тронув число партиций. И вот у тебя чудовищно неравномерные партиции. Либо репартиционируй явно, либо наслаждайся спиллами на диск. - Используй
.partitionBy()на записи, когда нижележащие джобы фильтруют по этим колонкам. Держи партиционирующие колонки низкокардинальными (не больше нескольких сотен уникальных значений)..partitionBy("user_id")на таблице пользователей — это катастрофа: миллионы крошечных директорий..partitionBy("date")на ежедневных данных — канонически правильный ответ.
Память
- Разберись в своей раскладке памяти. Дефолт: 60% памяти экзекьютора на execution + storage (
spark.memory.fraction), поделённые 50/50 (spark.memory.storageFraction). Оставшиеся 40% — пользовательская память. Не увеличивай память экзекьютора вслепую — пойми, какой пул кончается первым. Вкладка Storage в Spark UI показывает, что закэшировано; вкладка Executors — что занято. - Для PySpark: подними
memoryOverheadдо 20–25%. Дефолт — 10% или 384 МБ. Arrow и pandas UDF выделяют нативную память, которой не видно в метриках JVM. Твой экзекьютор убивает YARN или Kubernetes, и ты понятия не имеешь почему. Вот почему. - Не собирай данные на драйвере.
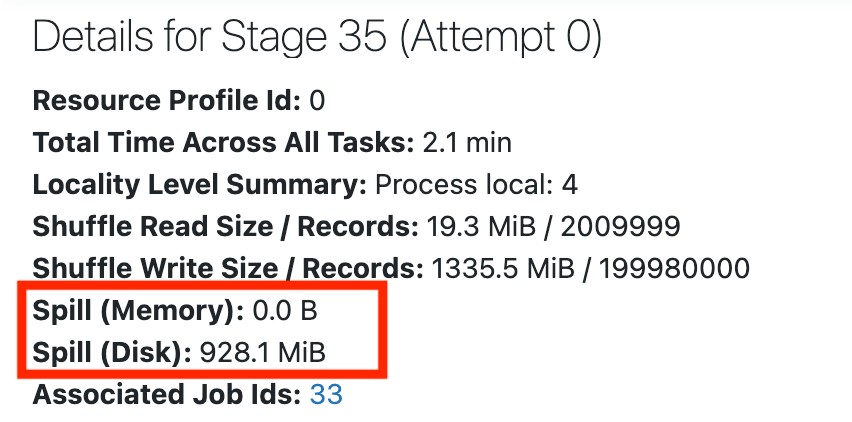
df.collect()тянет весь датасет на одну машину. Используй.take(),.takeSample()или.show(). То же касается.countByKey(),.countByValue(),.collectAsMap()— всё это на стороне драйвера. Spark пишет предупреждение, когда сериализованный размер таски превышает 1 МБ (TASK_SIZE_TO_WARN_KIB = 1000); за пределамиspark.driver.maxResultSize(дефолт 1 ГБ) — падает с ошибкой. - Следи за спиллами на диск. Смотри вкладку Stages в Spark UI. Если на стадии видишь «Spill (Memory)» или «Spill (Disk)»: уменьши объём данных на партицию (больше партиций), увеличь память экзекьютора, или и то и другое. Спилл означает, что данные не поместились и Spark записал промежуточный результат на диск. Это в 10–100 раз медленнее, чем в памяти.
- Используй off-heap-память для больших шафлов. Поставь
spark.memory.offHeap.enabled=trueиspark.memory.offHeap.sizeдля джоб с тяжёлыми шафлами или джойнами. Off-heap обходит давление GC и предсказуемее. Но платишь за это фиксированным выделением — и оно того стоит для всего, что регулярно спиллит.
Кэширование — оно не бесплатное
- Кэшируй только то, что переиспользуешь. Закэшировать DataFrame, к которому обращаешься один раз, — это просто отъесть память, которая могла уйти шафлам и джойнам. Кэшируй, когда есть ветвление логики, итеративные ML-нагрузки или несколько экшенов над одними данными.
- Форсируй материализацию после кэширования.
.cache()ленив. Пока не дёрнешь экшен, ничего не закэшировано. Всегда добавляй следом.count()или полный экшен. Иначе ты думаешь, что закэшировал, а это не так, и следующая джоба пересчитывает всё заново. - Ставь
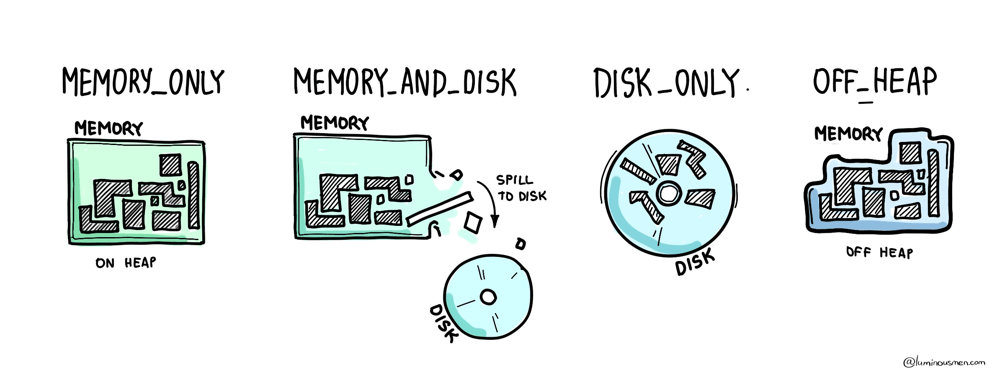
MEMORY_AND_DISKуровнем хранения по умолчанию. ЧистыйMEMORY_ONLYозначает, что при заполнении памяти данные молча вытесняются.MEMORY_AND_DISKспиллит на диск вместо пересчёта. Почти всегда это то, что тебе нужно. - Исходи из того, что кэш вытеснят. Кэш конкурирует с памятью выполнения. Spark вытесняет по LRU и не предупредит, когда выбросит твои блоки. Проектируй джобу так, чтобы она была корректна и без кэша — кэш нужен для скорости, а не для корректности.
- Остерегайся частичного кэширования.
.cache(), за которым идёт.take(10), материализует только те партиции, которых Spark коснулся ради 10 строк. Остальное не закэшировано, и следующий экшен пересчитает их без предупреждения. Всегда кэшируй сначала с.count()или полным экшеном.
Джойны — самый большой шафл в твоей жизни
- Броадкасти маленькие таблицы. Если одна сторона джойна меньше
spark.sql.autoBroadcastJoinThreshold(дефолт 10 МБ), Spark её броадкастит — никакого шафла, никакого обмена, просто хеш-лукап на каждом экзекьюторе. Для средних dim (10–200 МБ) подумай о том, чтобы поднять порог или использовать.broadcast(df)явно. За 200 МБ броадкаст обходится дороже, чем экономит. - Диагностируй перекос до того, как «чинить» джойны. Открой Spark UI, иди на вкладку Stages, посмотри на распределение длительности тасок. Если 99 тасок завершаются за 2 секунды, а одна идёт 40 минут — у тебя перекос. Обработка skewJoin в AQE (включена по умолчанию в 4.x) закрывает большинство случаев автоматически. Если не сработала: броадкасти маленькую сторону, посоли ключ джойна или сделай итеративный броадкаст-джойн.
- [4.x] Используй Storage Partition Join для предпартиционированных таблиц. Если обе стороны джойна приходят из источника DSv2 (Iceberg, Delta) и партиционированы по одним и тем же колонкам, SPJ (улучшения SPARK-51938 в 4.x) пропускает шафл целиком. Поставь
spark.sql.sources.v2.bucketing.enabled=true. Это самая крупная фича по устранению шафлов в Spark 4.x, и её преступно мало используют. - Бакетируй таблицы, когда SPJ недоступен. Для записи в Hive-стиле предварительно забакетируй обе таблицы по ключу джойна с одинаковым числом бакетов. Spark пропустит шафл на последующих джойнах. Паттерн старше SPJ, но для не-DSv2 источников по-прежнему актуален.
- Упорядочивай джойны от меньшего к большему, когда AQE не подхватывает. AQE переупорядочивает большинство джойнов сам, опираясь на рантайм-статистику, но если ты вне его досягаемости (например, путь через RDD или тяжёлый по шафлу план, который AQE не может переиграть) — ставь самую маленькую таблицу первой в явной цепочке джойнов.
JDBC-источники
Полный разбор параллельного чтения из JDBC — выбор колонки для партиционирования, границы, размер выборки и то, как каждое из этого ломается.
- Задай
numPartitionsдля параллельного чтения. По умолчанию чтение из JDBC грузит всё в одну партицию на одном экзекьюторе. Поставь.option("numPartitions", N)вместе с.partitionColumn(),.lowerBound()и.upperBound(), чтобы распараллелить. Это может быть разница между чтением в 2 часа и чтением в 5 минут. - Используй predicates для нечислового партиционирования. Если ключ партиционирования не укладывается в чистый числовой диапазон, передай массив SQL-условий WHERE через
.option("predicates", ...). Одна таска на предикат, диапазоны размечены руками. Некрасиво, но работает. - Пробрасывай что можешь и не рассчитывай, что драйвер сделает это за тебя. Spark автоматически пробрасывает в JDBC базовые фильтры (равенство по колонке, IN, IS NULL), но всё, где есть вычисляемая колонка или каст, не пробросится и будет вычисляться в Spark уже после полного чтения. Для сложных предикатов пиши фильтр явно в опции запроса, а не надейся на pushdown.
Что на самом деле изменилось в Spark 4.x
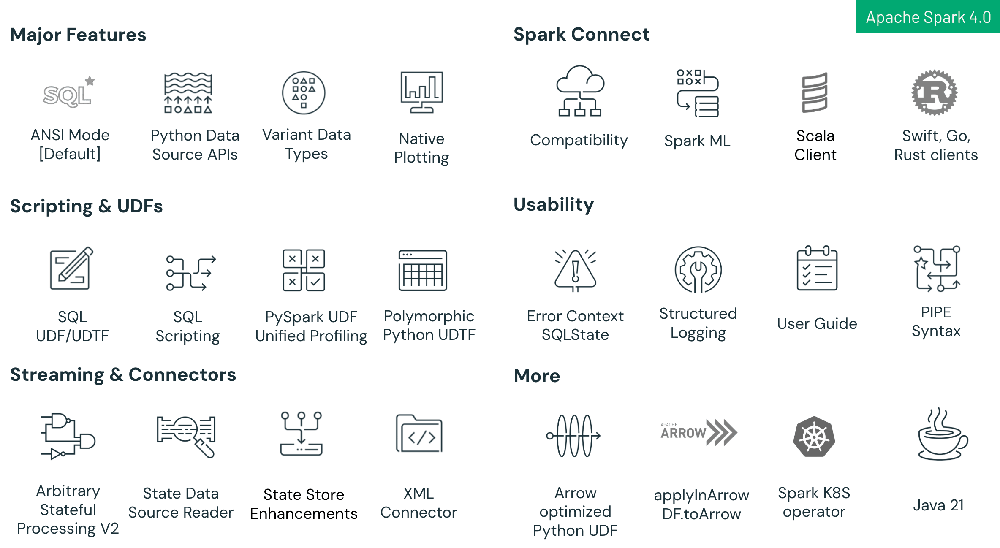
Источник: блог Databricks
Раньше эти пункты требовали конфиг-флагов. В 4.x они включены по умолчанию. Если ты копипастишь старые конфиги дальше, часть из них теперь избыточна, а пара штук тихо делает обратное тому, что ты думаешь.
- [4.x] AQE включён по умолчанию. Хватит его переключать. spark.sql.adaptive.enabled=true — дефолт с 3.2. Если копипастишь конфиги, где он выставлен явно, вычисти их. О чём стоит думать вместо этого: adaptive.coalescePartitions.parallelismFirst (дефолт false — ставь true, если хочешь, чтобы AQE ставил параллелизм выше размера партиции) и пороги skew-джойна, если данные необычные.
- [4.x] DPP включён по умолчанию и теперь многоключевой. Та же история — хватит дёргать dynamicPartitionPruning.enabled. Что в 4.x действительно важно, так это SPARK-46946: DPP теперь броадкастит несколько ключей, так что джойны против факт-таблиц с составными партициями отсекаются в рантайме.
- [4.x] RocksDB — бэкенд БД для shuffle service по умолчанию (SPARK-45351). Если ты гоняешь внешний shuffle service с базой под ним, это поменялось у тебя под ногами. Обычно к лучшему, но после апгрейда стоит посмотреть на метрики ESS.
- [4.x]
spark.shuffle.service.removeShuffleвключён по умолчанию (SPARK-47448). Данные шафла чистятся автоматически, когда ссылающиеся RDD собраны сборщиком мусора. Твоя проблема из 3.x «диск на кластере забивается после длинных джоб», вероятно, ушла. Если не ушла — проверь линидж, что-то держит ссылки. - [4.x] Параллельные ZSTD/LZF для сжатия шафла. SPARK-46256 и SPARK-48518. Если ты до сих пор на дефолтном Snappy для сжатия шафла, ты не используешь параллелизм CPU на современных многоядерных экзекьюторах. Поставь
spark.shuffle.compress=true(дефолт) иspark.io.compression.codec=zstd. - Kryo против Java-сериализатора — всё ещё стоит того. По умолчанию до сих пор Java, а он в 2–10 раз медленнее и толще на проводе.
spark.serializer=org.apache.spark.serializer.KryoSerializer. Ты платишь эту цену на каждом шафле. Регистрируй свои классы (spark.kryo.classesToRegisterилиspark.kryo.registrator), иначе Kryo молча откатится на Java для незарегистрированных типов.
Перед выкаткой в прод
- Действительно прочитай Spark UI. Посмотри на DAG, на таймлайн стадий, на распределение тасок. Большинство проблем с производительностью видно в UI, если не полениться посмотреть. Неровные полоски тасок — перекос. Много стадий — лишние шафлы. Красные полоски в разделе стадий — спиллы. Вкладка SQL показывает физический план с рантайм-статистикой — вот там становятся видны решения AQE.
- Сначала мониторь, потом тюнингуй. Не гадай. Не оптимизируй заранее. Запусти джобу, посмотри метрики, потом правь. Поднять память экзекьютора до 64 ГБ «на всякий случай» — это переплата. И платить за неё ты будешь каждый день, пока кто-нибудь не полезет в счёт.
- Используй
.localCheckpoint(), чтобы разорвать линидж. Длинные цепочки трансформаций строят гигантские планы выполнения. Чекпоинт перед репартиционированием и записью разбивает план на управляемые стадии и может предотвратить переполнение стека на глубоко вложенных DAG. А ещё это единственный дешёвый способ обрезать линидж, когда у тебя нет надёжного распределённого хранилища. - Включи метрики Prometheus.
spark.ui.prometheus.enabled=trueвключён по умолчанию в 4.x (SPARK-46886). Скрапь эндпоинты экзекьюторов в тот observability-стек, который у тебя есть. Если у тебя нет метрик по давлению на память экзекьюторов и пропускной способности шафла — ты тюнингуешь вслепую. - Поставь таймаут на джобу.
spark.task.reaper.killTimeoutплюс отсечка на уровне драйвера. Без неё сбежавшая джоба будет жечь деньги кластера все выходные, прежде чем кто-нибудь заметит.
TLDR;
Если запомнишь только пять вещей:
- Используй DataFrame API. Всё остальное в этом списке на нём держится.
- Фильтруй и отсекай партиции как можно раньше. Не считай по строкам, которые всё равно выбросишь.
- Найди свой перекос прежде, чем тюнинговать что-либо ещё. Одна медленная таска из 200 — это и есть вся проблема в 80% случаев.
- AQE, DPP, SPJ включены по умолчанию в 4.x. Знай, что они делают, чтобы перестать настраивать их дважды и начать замечать, когда они не срабатывают.
- Читай UI. Ответ почти всегда в UI, если посмотреть.
Хочешь это в виде PDF для печати? Подпишись на luminousmen.substack.com, и я пришлю — плюс новый глубокий разбор по дата-инжинирингу каждый понедельник.