He cometido todos los errores tontos de Spark al menos una vez. A escala de producción — datos reales, concurrencia real, stakeholders reales gritando en Slack — "funciona" y "funciona bien" son dos conversaciones completamente distintas. Así que empecé a apuntarlos.
Esta es la checklist que ojalá hubiera tenido pegada al monitor cuando empecé. Cada punto sale de un desastre real en producción, mío o de otro.
Antes de escribir una sola línea
- Usa la API de DataFrame / Dataset, no RDDs. Los RDD van guiados por lambdas — Spark no puede ver dentro de ellos ni optimizarlos. Los DataFrame pasan por el optimizador Catalyst. Consigues gratis pushdown de predicados, reordenación de filtros, Adaptive Query Execution y reordenación de joins basada en costes. La API de RDD en MLlib está en modo mantenimiento. Suéltala.
- Elige el formato de fichero correcto. Parquet para consultas analíticas — poda de columnas, pushdown de predicados y salto por estadísticas funcionan de serie. Avro para ingesta con mucha evolución de esquema. Para cualquier cosa que se lea más de una vez en la misma semana, pon encima un formato de tabla — Iceberg o Delta — y tendrás ACID, time travel y estadísticas que el planificador sí puede usar. Si lees CSV o JSON crudo, especifica siempre el esquema de forma explícita. La inferencia implica un escaneo completo solo para averiguar los tipos.
- Usa compresión splittable. Snappy, LZ4 o ZSTD — nunca GZIP. Un fichero GZIP de 10 GB no se puede dividir entre executors: un pobre nodo tiene que descomprimirlo entero. Snappy es el valor por defecto fiable. ZSTD comprime más y, desde Spark 4.x, corre en paralelo para el shuffle (SPARK-46256) — úsalo para los spills de shuffle y los ficheros intermedios y recortarás tiempo de red.
- Conoce tu versión de Spark. Spark 4.0 eliminó Scala 2.12, JDK 8, JDK 11, Mesos y Python 3.8. Si tu equipo de plataforma sigue en alguno de esos, esa es la primera batalla que hay que dar: el resto de esta checklist da por hecho que estás en JDK 17, Scala 2.13 y Python 3.9+. No ajustes un job sobre una plataforma que ya va una etapa por detrás.
Particionado — la arquitectura invisible
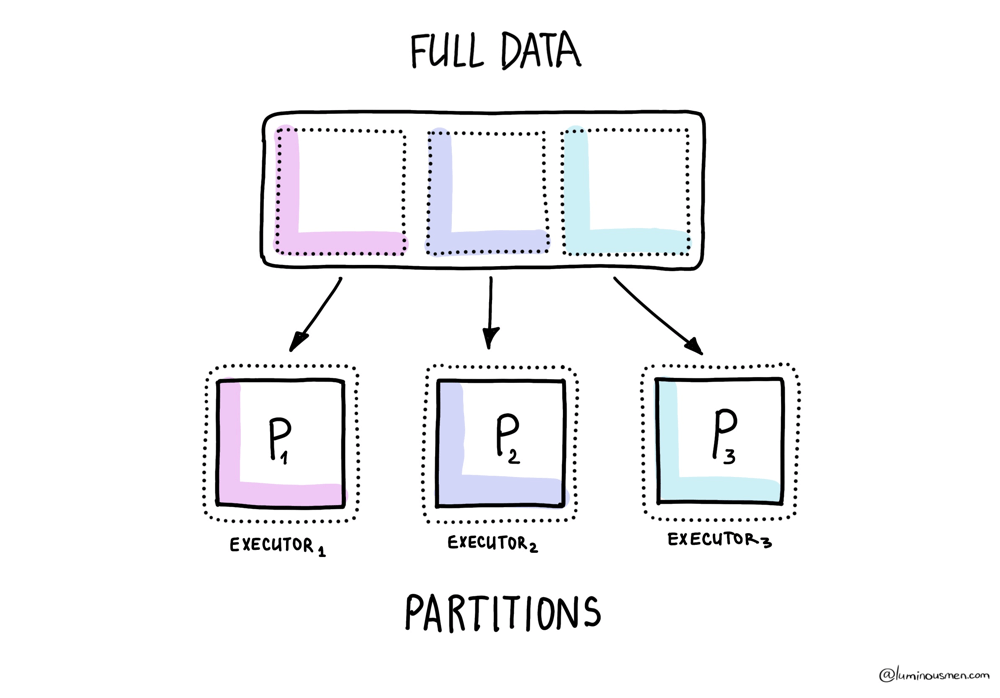
Análisis completo de las particiones de Spark — cómo decide Spark el número de particiones y todas las palancas que lo cambian.
- Ajusta
spark.sql.files.maxPartitionBytesa tu distribución de almacenamiento. Por defecto son 128 MB. Si tus ficheros Parquet son en su mayoría de 256 MB o más, estás infraparalelizando las lecturas. Si son de 8 MB, tienes demasiadas tareas. Ajusta el tamaño de split a tu distribución real de ficheros, no al valor por defecto de Spark. Esta es la palanca del lado de entrada: fija el número inicial de particiones antes de que entre el coalescing de AQE. - Apunta a 2-4 particiones por core disponible. Menos y los cores se quedan parados. Más y el planificador gasta más tiempo llevando la cuenta de las tareas que ejecutándolas. Si las tareas terminan habitualmente en menos de 100 ms, tus particiones son demasiado pequeñas. Si una tarea tarda 10 veces más que las demás, tienes sesgo — mira la sección de joins.
- Filtra pronto, filtra fuerte. Empuja los filtros lo más cerca posible de la fuente de datos. La poda de particiones existe por algo: si tus datos están particionados por fecha y solo necesitas la última semana, Spark no debería tocar las otras 51. Con Dynamic Partition Pruning (activado por defecto en 4.x) esto funciona además en tiempo de ejecución a través de joins. Lo que me lleva al siguiente punto.
- [4.x] Usa Dynamic Partition Pruning multiclave para particiones compuestas. SPARK-46946 añadió DPP multiclave. Si tu tabla de hechos está particionada por (date, region) y la unes con una dim pequeña ya filtrada, Spark ahora poda por ambas claves en tiempo de ejecución. Esto desbloquea un rendimiento de esquema en estrella que era imposible en 3.x. No hace falta configuración: funciona solo si el lado de la dim se difunde por broadcast.
- Haz coalesce después de un filtrado fuerte. Acabas de filtrar 2.000 millones de filas hasta 2 millones y sigues con 10.000 particiones. Eso son 10.000 tareas casi vacías.
.coalesce()lo arregla sin un shuffle completo..repartition()si necesitas distribución uniforme en el nuevo número de particiones. El coalescePartitions de AQE gestiona automáticamente el coalescing de la salida del shuffle, pero no te ayudará con el número de particiones del lado de entrada después de filtrar. - Reparticiona por las claves del join antes de varios joins. Si unes el mismo DataFrame tres veces por user_id, reparticiona por user_id una vez y cachéalo. Si no, estás moviendo los mismos datos tres veces. Mejor aún: si la tabla es de larga vida, aplícale bucketing — mira la sección de joins.
- Reparticiona después de
flatMap. flatMap puede multiplicar por 10 tu número de filas sin tocar el número de particiones. Y ahí tienes particiones enormemente desiguales. O reparticionas explícitamente o disfrutas de tus spills a disco. - Usa
.partitionBy()al escribir cuando los jobs de aguas abajo filtran por esas columnas. Limita las columnas de particionado a baja cardinalidad (como mucho unos cientos de valores distintos)..partitionBy("user_id")en una tabla de usuarios es un desastre: millones de directorios minúsculos..partitionBy("date")sobre datos diarios es la respuesta canónicamente correcta.
Memoria
- Conoce tu distribución de memoria. Por defecto: 60% de la memoria del executor para execution + storage (
spark.memory.fraction), repartido 50/50 (spark.memory.storageFraction). El 40% restante es memoria de usuario. No aumentes la memoria del executor a ciegas: entiende qué pool se está agotando primero. La pestaña Storage de la Spark UI te dice qué hay cacheado; la pestaña Executors, qué está en uso. - Para PySpark: sube
memoryOverheadal 20-25%. Por defecto es el 10% o 384 MB. Arrow y las UDF de pandas reservan memoria nativa que no aparece en las métricas de la JVM. YARN o Kubernetes matan tu executor y no tienes ni idea de por qué. Por esto. - No hagas collect en el driver.
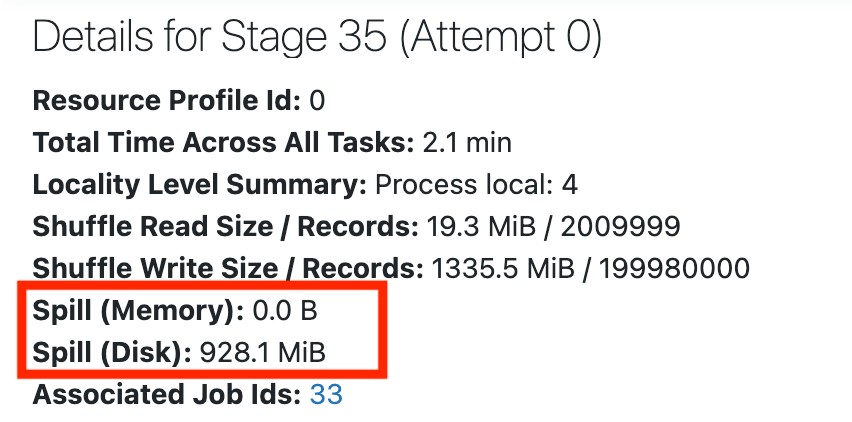
df.collect()trae el dataset entero a una sola máquina. Usa.take(),.takeSample()o.show(). Lo mismo con.countByKey(),.countByValue(),.collectAsMap()— todo eso ocurre en el driver. Spark avisa cuando el tamaño serializado de una tarea supera 1 MB (TASK_SIZE_TO_WARN_KIB = 1000); pasadospark.driver.maxResultSize(1 GB por defecto), falla directamente. - Vigila los spills a disco. Mira la pestaña Stages de la Spark UI. Si ves "Spill (Memory)" o "Spill (Disk)" en una etapa: reduce los datos por partición (más particiones), aumenta la memoria del executor, o ambas. Un spill significa que los datos no cabían y Spark escribió resultados intermedios en disco. Eso es entre 10 y 100 veces más lento que en memoria.
- Usa memoria off-heap para shuffles grandes. Pon
spark.memory.offHeap.enabled=trueyspark.memory.offHeap.sizeen jobs con shuffles o joins pesados. Off-heap esquiva la presión del GC y es más predecible. Pero lo pagas con una reserva fija — y merece la pena para cualquier cosa que haga spill con regularidad.
Caché — no es gratis
- Cachea solo lo que reutilizas. Cachear un DataFrame que tocas una sola vez es malgastar memoria que podría ir a shuffles y joins. Cachea cuando tengas lógica con ramas, cargas de ML iterativas o varias acciones sobre los mismos datos.
- Fuerza la materialización después de cachear.
.cache()es perezoso. Hasta que no dispares una acción, no hay nada cacheado. Añade siempre después un.count()o una acción completa. Si no, crees que lo has cacheado pero no, y el siguiente job lo recalcula todo. - Usa
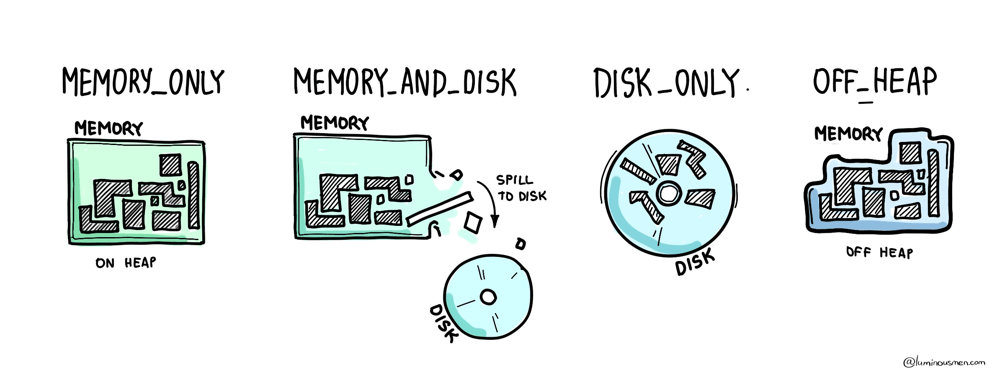
MEMORY_AND_DISKcomo nivel de almacenamiento por defecto.MEMORY_ONLYpuro significa que los datos se desalojan en silencio cuando la memoria se llena.MEMORY_AND_DISKhace spill a disco en vez de recalcular. Casi siempre es lo que quieres. - Da por hecho que tu caché será desalojada. La caché compite con la memoria de ejecución. Spark desaloja por LRU y no te avisará cuando tire tus bloques cacheados. Diseña el job para que sea correcto incluso sin la caché: la caché es para velocidad, no para corrección.
- Cuidado con el cacheado parcial. Un
.cache()seguido de.take(10)solo materializa las particiones que Spark tocó para conseguir 10 filas. El resto no está cacheado y la siguiente acción las recalcula sin avisar. Cachea siempre primero con un.count()o una acción completa.
Joins — el shuffle más grande de tu vida
- Difunde las tablas pequeñas por broadcast. Si un lado de tu join está por debajo de
spark.sql.autoBroadcastJoinThreshold(10 MB por defecto), Spark lo difunde: sin shuffle, sin intercambio, solo una búsqueda hash en cada executor. Para dims medianas (10-200 MB), plantéate subir el umbral o usar.broadcast(df)de forma explícita. Pasados los 200 MB, el broadcast cuesta más de lo que ahorra. - Diagnostica el sesgo antes de "arreglar" los joins. Abre la Spark UI, ve a la pestaña Stages y mira la distribución de duración de las tareas. Si 99 tareas terminan en 2 segundos y una tarda 40 minutos, tienes sesgo. El manejo de skewJoin de AQE (activado por defecto en 4.x) cubre la mayoría de los casos automáticamente. Si no salta: difunde el lado pequeño, saltea la clave del join o haz un broadcast join iterativo.
- [4.x] Usa Storage Partition Join para tablas ya particionadas. Si ambos lados del join vienen de una fuente DSv2 (Iceberg, Delta) y están particionados por las mismas columnas, SPJ (mejoras de SPARK-51938 en 4.x) se salta el shuffle por completo. Pon
spark.sql.sources.v2.bucketing.enabled=true. Es la mayor funcionalidad de eliminación de shuffles de Spark 4.x y está criminalmente infrautilizada. - Aplica bucketing a tus tablas cuando SPJ no sea una opción. Para escrituras estilo Hive, pre-bucketea ambas tablas por la clave del join con el mismo número de buckets. Spark se salta el shuffle en joins posteriores. Es un patrón más antiguo que SPJ pero sigue siendo relevante para fuentes que no son DSv2.
- Ordena los joins de menor a mayor cuando AQE no cubra el hueco. AQE reordena la mayoría de los joins automáticamente según estadísticas de ejecución, pero si estás fuera de su alcance (por ejemplo, la ruta de RDD, o un plan con tanto shuffle que AQE no puede reintentarlo), pon la tabla más pequeña primero en tu cadena explícita de joins.
Fuentes JDBC
Análisis completo de las lecturas JDBC en paralelo — elección de la columna de particionado, límites, tamaño de fetch y cómo falla cada una de esas cosas.
- Configura
numPartitionspara leer en paralelo. Por defecto, las lecturas JDBC cargan todo en una sola partición de un solo executor. Pon.option("numPartitions", N)junto con.partitionColumn(),.lowerBound()y.upperBound()para paralelizar. Puede ser la diferencia entre una lectura de 2 horas y una de 5 minutos. - Usa predicates para particionar por columnas no numéricas. Si tu clave de particionado no es un rango numérico limpio, pasa un array de cláusulas SQL WHERE con
.option("predicates", ...). Una tarea por predicado, rangos dimensionados a mano. Feo pero efectivo. - Empuja lo que puedas y no confíes en que el driver lo haga por ti. Spark empuja automáticamente a JDBC los filtros básicos (igualdad de columna, IN, IS NULL), pero cualquier cosa con una columna calculada o un cast no bajará y se evaluará en Spark después de la lectura completa. Para predicados complejos, escribe el filtro explícitamente en una opción de consulta en vez de fiarte del pushdown.
Qué cambió realmente en Spark 4.x
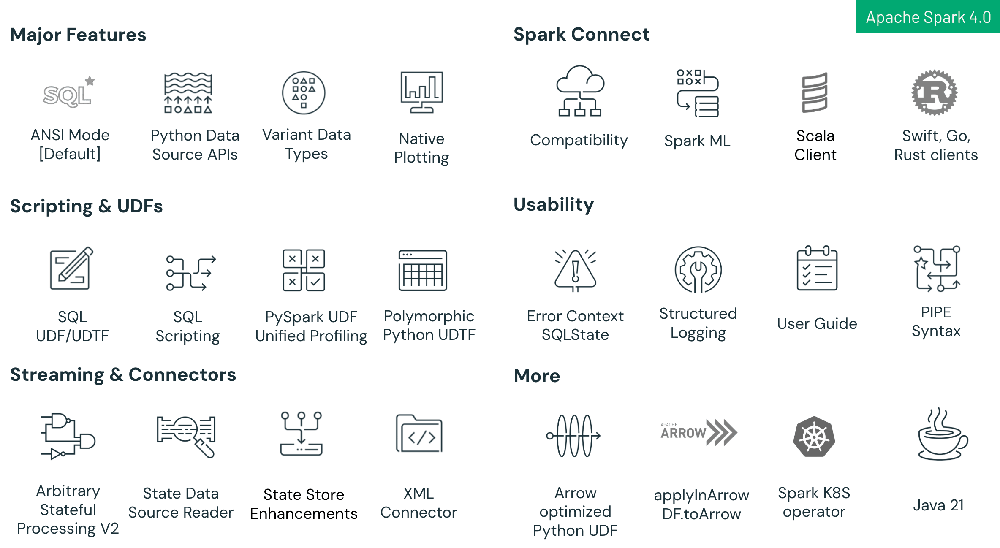
Fuente: blog de Databricks
Estos puntos antes requerían flags de configuración. En 4.x vienen activados por defecto. Si vas arrastrando configuraciones antiguas por copia y pega, algunas ya son redundantes y un par están haciendo en silencio lo contrario de lo que crees.
- [4.x] AQE viene activado. Deja de encenderlo y apagarlo. spark.sql.adaptive.enabled=true es el valor por defecto desde 3.2. Si copias y pegas configuraciones que lo fijan explícitamente, límpialas. De qué preocuparse en su lugar: adaptive.coalescePartitions.parallelismFirst (false por defecto — ponlo en true si quieres que AQE priorice el paralelismo sobre el tamaño de partición) y los umbrales de skew join si tus datos son raros.
- [4.x] DPP viene activado, y ahora es multiclave. La misma historia: deja de tocar dynamicPartitionPruning.enabled. La mejora que importa en 4.x es SPARK-46946: DPP ahora difunde varias claves, así que los joins contra tablas de hechos con particiones compuestas podan en tiempo de ejecución.
- [4.x] RocksDB es el backend de base de datos por defecto del shuffle service (SPARK-45351). Si ejecutas el external shuffle service con una base de datos detrás, esto te ha cambiado bajo los pies. Suele ser una mejora, pero conviene revisar las métricas del ESS tras actualizar.
- [4.x]
spark.shuffle.service.removeShuffleviene activado (SPARK-47448). Los datos de shuffle se limpian automáticamente cuando los RDD referenciados pasan por el recolector de basura. Tu problema de 3.x de "el disco del clúster se llena después de jobs largos" probablemente ya no exista. Si sigue ahí, revisa tu linaje: algo está reteniendo referencias. - [4.x] ZSTD/LZF en paralelo para la compresión del shuffle. SPARK-46256 y SPARK-48518. Si sigues con Snappy por defecto para comprimir el shuffle, estás dejando sin usar el paralelismo de CPU en executors modernos multinúcleo. Pon
spark.shuffle.compress=true(por defecto) yspark.io.compression.codec=zstd. - Kryo frente al serializador de Java — sigue mereciendo la pena. Por defecto sigue siendo Java, que es entre 2 y 10 veces más lento y más pesado en la red.
spark.serializer=org.apache.spark.serializer.KryoSerializer. Pagas ese coste en cada shuffle. Registra tus clases propias (spark.kryo.classesToRegisterospark.kryo.registrator) o Kryo volverá a Java en silencio para los tipos no registrados.
Antes de llevarlo a producción
- Lee de verdad la Spark UI. Mira el DAG, la línea temporal de etapas, la distribución de tareas. La mayoría de los problemas de rendimiento se ven en la UI si te molestas en mirar. Barras de tarea desiguales = sesgo. Muchas etapas = shuffles innecesarios. Barras rojas en la vista de etapas = spills. La pestaña SQL te muestra el plan físico con estadísticas de ejecución: ahí es donde se hacen visibles las decisiones de AQE.
- Primero monitoriza, después ajusta. No adivines. No preoptimices. Ejecuta el job, mira las métricas y luego ajusta. Subir la memoria del executor a 64 GB "por si acaso" es sobreaprovisionar. Y lo seguirás pagando cada día hasta que alguien audite la factura.
- Usa
.localCheckpoint()para romper el linaje. Las cadenas largas de transformaciones construyen planes de ejecución enormes. Un checkpoint antes de un reparticionado y escritura parte el plan en etapas manejables y puede evitar desbordamientos de pila en DAG muy anidados. Además es la única forma barata de truncar el linaje cuando no tienes almacenamiento distribuido fiable. - Activa las métricas de Prometheus.
spark.ui.prometheus.enabled=trueviene activado por defecto en 4.x (SPARK-46886). Recoge los endpoints de los executors en el stack de observabilidad que tengas. Si no tienes métricas de presión de memoria en los executors y de rendimiento del shuffle, estás ajustando a ciegas. - Pon un timeout al job.
spark.task.reaper.killTimeouty un corte a nivel de driver. Sin eso, un job desbocado quemará presupuesto de clúster todo el fin de semana antes de que nadie se dé cuenta.
TLDR;
Si solo recuerdas cinco cosas:
- Usa la API de DataFrame. Todo lo demás de esta lista depende de ello.
- Filtra y poda particiones lo antes posible. No calcules sobre filas que vas a tirar.
- Encuentra tu sesgo antes de ajustar cualquier otra cosa. Una tarea lenta de cada 200 es todo el problema el 80% de las veces.
- AQE, DPP y SPJ vienen activados en 4.x. Entiende qué hacen para dejar de configurarlos por duplicado y empezar a notar cuándo no se disparan.
- Lee la UI. La respuesta casi siempre está en la UI si te fijas.
¿Lo quieres como PDF imprimible? Suscríbete en luminousmen.substack.com y te lo envío — además de un análisis profundo de ingeniería de datos cada lunes.