
Пайплайны данных — как сердцебиение для любой data-driven компании. Без них никуда, и при этом большую часть времени они ощущаются как обуза. Ты вытаскиваешь данные из одного места, чистишь их, сбрасываешь куда-то ещё и надеешься, что их используют для чего-то осмысленного. Десятилетиями основным методом для этого был ETL (Extract, Transform, Load). Потом появился ELT, где трансформация происходит уже после загрузки — это экономит время и даёт гибкость.
А теперь? Reverse ETL снова переворачивает сценарий — не просто загружает данные в хранилище, а выталкивает их обратно наружу, чтобы команды могли реально что-то с ними сделать. Свежо, да?
Разбираемся с ETL и ELT

Основы ETL
Extract, Transform, Load (ETL) десятилетиями был основой data-воркфлоу. Он состоит из:
- Extract: данные собираются из разных источников — приложений, сайтов, CRM-платформ и других систем-источников.
- Transform: на этом шаге сырые данные очищаются, дедуплицируются, валидируются и приводятся к единой модели данных, чтобы обеспечить консистентность и сохранить целостность. В процессе применяются бизнес-правила и трансформации, которые готовят данные к загрузке в целевую базу.
- Load: финальный шаг — сохранить очищенные и упорядоченные данные в целевой системе: операционном хранилище, витрине данных, data lake или хранилище данных.
Но линейный процесс ETL часто приводил к узким местам — особенно на фоне экспоненциального роста объёма и сложности данных. Трансформировать данные до загрузки в хранилище было долго и негибко, особенно для неструктурированных данных, которых сейчас всё больше. В ответ на это появился подход ELT.
Переход к ELT
Extract, Load, Transform (ELT) переворачивает традиционную модель: извлечённые данные сначала загружаются в целевую систему. Выполняя трансформации после загрузки, ELT использует масштабируемость и параллелизм современных облачных хранилищ данных и эффективно справляется с огромными датасетами и сложными операциями.
Этот сдвиг был не только про скорость — он также дал больше гибкости в управлении и анализе разных типов данных. Такой подход позволяет выполнять ресурсоёмкие операции вроде продвинутой аналитики и поддерживает downstream-воркфлоу, включая ML-пайплайны, которые используют данные из хранилища.
С переходом от ETL к ELT хранилище данных становится ядром твоей экосистемы данных. Вместо того чтобы просто хранить структурированные данные, оно работает как движок обработки всего — от real-time инсайтов до продвинутых алгоритмов. Этот ключевой сдвиг стал возможен благодаря набору мощных инструментов: Fivetran и Airbyte упрощают извлечение и загрузку, DBT занимается трансформацией, а надёжные решения для хранилищ вроде Snowflake и Redshift хранят данные. Хотя традиционно эти технологии обслуживали аналитику и BI (например, Looker и Superset), всё чаще признаётся их потенциал для более динамичной операционной аналитики — доставки данных в реальном времени для действенных инсайтов.
Сегодня многие новые платформы интеграции данных поддерживают и ETL, и ELT, часто динамически выбирая подход в зависимости от use case.
Тогда что такое Reverse ETL?
ETL и ELT упорядочили хранение и анализ данных, но не закрыли до конца потребность в том, чтобы эти данные использовать в работе. Reverse ETL извлекает обогащённые данные из хранилища и синхронизирует их в операционные инструменты — CRM, маркетинговые платформы, инструменты продаж или системы поддержки клиентов — для немедленного использования.
Представь это как двунаправленный поток данных: ETL (или ELT) занимается тем, чтобы переместить сырые данные в хранилище для консолидации и анализа. Reverse ETL наоборот — извлекает эти очищенные и обогащённые данные из хранилища (где живут все ключевые бизнес-определения и данные, готовые к действию) и активно доставляет их в downstream-инструменты для немедленного использования в организации.
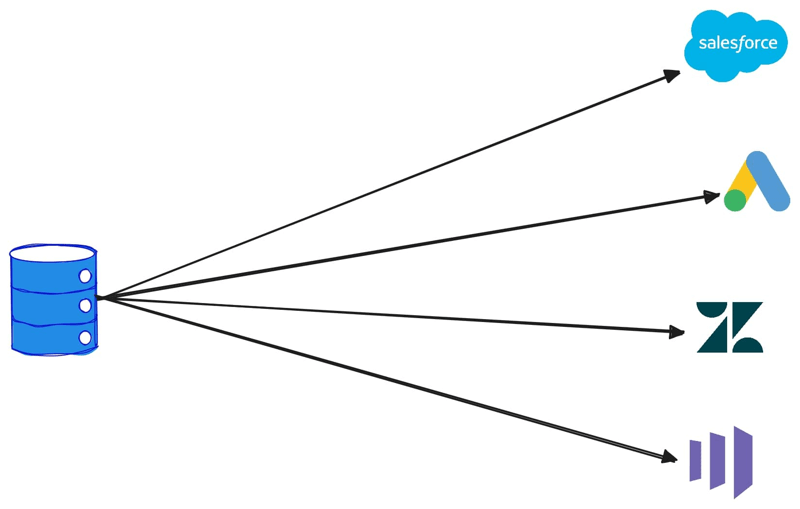
Такой подход обеспечивает своевременные и консистентные данные во всех операционных инструментах, что даёт лучшую согласованность между бизнес-приложениями. Reverse ETL работает как инструмент синхронизации, поддерживая консистентность и предоставляя актуальную информацию по всему набору приложений компании. По сути, он превращает хранилище данных из просто места хранения в важный хаб для постоянного улучшения данных и стратегических инсайтов — так данные начинают вести к более обоснованным решениям и действиям по всей компании.
Плюсы Reverse ETL
- Активация данных: нетехнические команды получают возможность использовать данные из хранилища для работы с клиентами и других бизнес-операций, что значительно повышает ценность этих данных.
- Больше эффективности в инженерии: Reverse ETL снимает нагрузку с дата-инженеров, которым иначе пришлось бы утонуть в разработке и поддержке кастомных API-интеграций для маркетинга и других команд.
- Доступность для нетехнических команд: ускоряет процесс предоставления данных из хранилища бизнес-командам, убирая необходимость в постоянной поддержке со стороны инженеров.
Сложности Reverse ETL
Среди сложностей Reverse ETL — управление лимитами API (rate limits), обеспечение безопасности данных при передаче и поддержание свежести данных в операционных системах. Эти проблемы требуют надёжных решений и стратегий, чтобы операционные выгоды Reverse ETL реализовались без ущерба для целостности данных или производительности.
Ещё одна критичная сложность — data governance, которая становится ещё важнее, когда аналитические данные текут обратно в операционные системы. Подача обогащённых данных в инструменты вроде CRM или маркетинговых платформ создаёт новые требования к:
- Качеству данных: аналитические данные часто берутся из нескольких систем с разной степенью чистоты. Без строгих проверок качества ошибки или несоответствия могут расползтись по downstream-воркфлоу, подрывая доверие к данным.
- Контролю доступа: операционные инструменты могут открыть чувствительные данные более широкой аудитории. Чтобы предотвратить несанкционированный доступ, нужны строгие ролевые разрешения и стратегии анонимизации.
- Мониторингу: синхронизация данных между системами в масштабе требует активного мониторинга, чтобы ловить несоответствия, ошибки или задержки. Надёжные фреймворки мониторинга гарантируют, что потоки данных остаются надёжными и соответствуют требованиям.
Если не разобраться с этими вопросами governance, Reverse ETL рискует создать новые силосы, распространить неточности или даже породить проблемы с комплаенсом.
Инструменты и технологии
Формируется живая экосистема решений для reverse ETL — впереди стартапы вроде Hightouch, Census, Grouparoo (open source), Polytomic, Rudderstack и Seekwell. Даже платформы вроде Workato встраивают функциональность reverse ETL с дифференциальной синхронизацией.
Заключение
Reverse ETL превращается из нишевого решения в ключевой компонент современного data stack. Его способность раскрыть весь потенциал хранилищ данных и бесшовно интегрироваться с разными бизнес-системами меняет то, как мы взаимодействуем с данными. По мере развития этой экосистемы перспективы для перестройки data-операций и аналитики выглядят безграничными. Этот подход быстро становится стандартом современного data stack, используя существующие активы данных беспрецедентными способами.