
Los data pipelines son como el latido del corazón de cualquier empresa data-driven. Son esenciales, y aun así, la mayor parte del tiempo se sienten como una carga. Sacas datos de un lugar, los limpias, los tiras en otro lado y esperas que se usen para algo que valga la pena. Durante décadas, ETL (Extract, Transform, Load) fue el método de referencia para hacer esto. Después llegó ELT, donde la transformación ocurre después de la carga, ahorrando tiempo y dando flexibilidad.
¿Y ahora? Reverse ETL vuelve a dar vuelta el guion: no solo mueve datos hacia un warehouse, sino que los empuja hacia afuera para que los equipos puedan hacer algo con ellos de verdad. Novedoso, ¿no?
Entendiendo ETL y ELT

Fundamentos de ETL
Extract, Transform, Load (ETL) ha sido la columna vertebral de los flujos de datos durante décadas. Consiste en:
- Extract: los datos se recopilan de varias fuentes, como aplicaciones, sitios web, plataformas de CRM y otros sistemas de origen.
- Transform: en este paso, los datos crudos se limpian, se deduplican, se validan y se reorganizan en un modelo de datos unificado para garantizar consistencia y mantener la integridad de los datos. Durante este proceso se aplican reglas de negocio y transformaciones que preparan los datos para cargarlos en la base de datos de destino.
- Load: el paso final es almacenar los datos limpios y organizados en el sistema de destino, ya sea un data store operacional, data mart, data lake o data warehouse.
Sin embargo, el proceso lineal de ETL a menudo generaba cuellos de botella, sobre todo con el crecimiento exponencial en volumen y complejidad de los datos. Transformar los datos antes de cargarlos en el warehouse llevaba mucho tiempo y era menos flexible, especialmente para datos no estructurados, que hoy son comunes. Como respuesta, surgió el enfoque ELT.
El cambio hacia ELT
Extract, Load, Transform (ELT) da vuelta el modelo tradicional cargando primero los datos extraídos en el sistema de destino. Al hacer las transformaciones después de la carga, ELT aprovecha la escalabilidad y el paralelismo de los data warehouses en la nube modernos, manejando datasets enormes y operaciones complejas de forma eficiente.
Este cambio no fue solo cuestión de velocidad; también ofreció más flexibilidad para gestionar y analizar distintos tipos de datos. Este enfoque habilita operaciones intensivas en recursos como la analítica avanzada y da soporte a los flujos downstream, incluidos los pipelines de machine learning que usan datos del warehouse.
Con la transición de ETL a ELT, el data warehouse se convierte en el núcleo de tu ecosistema de datos. En lugar de solo almacenar datos estructurados, funciona como el motor de procesamiento de todo, desde insights en tiempo real hasta algoritmos avanzados. Este cambio clave fue posible gracias a un conjunto de herramientas potentes: Fivetran y Airbyte simplifican la extracción y la carga, DBT se encarga de la transformación, y soluciones de warehousing robustas como Snowflake y Redshift almacenan los datos. Aunque tradicionalmente estas tecnologías apuntaban a aplicaciones de analítica y business intelligence (piensa en Looker y Superset), cada vez se reconoce más su potencial para una analítica operacional más dinámica, que entrega datos en tiempo real para insights accionables.
Hoy, muchas plataformas nuevas de integración de datos soportan tanto ETL como ELT, y a menudo eligen de forma dinámica según el caso de uso.
¿Entonces qué es Reverse ETL?
Mientras que ETL y ELT optimizaron el almacenamiento y el análisis de datos, no resolvieron del todo la necesidad de poner esos datos a trabajar. Reverse ETL se enfoca en extraer datos enriquecidos del warehouse y sincronizarlos con herramientas operacionales como CRMs, plataformas de marketing, herramientas de ventas o sistemas de soporte al cliente para usarlos de inmediato.
Imagínalo como un flujo bidireccional de datos: ETL (o ELT) se enfoca en mover datos crudos hacia el warehouse para consolidarlos y analizarlos. Reverse ETL, al revés, se concentra en extraer esos datos limpios y enriquecidos desde el data warehouse (donde viven todas tus definiciones de negocio centrales y los datos accionables) y desplegarlos activamente en herramientas downstream para su uso inmediato en la organización.
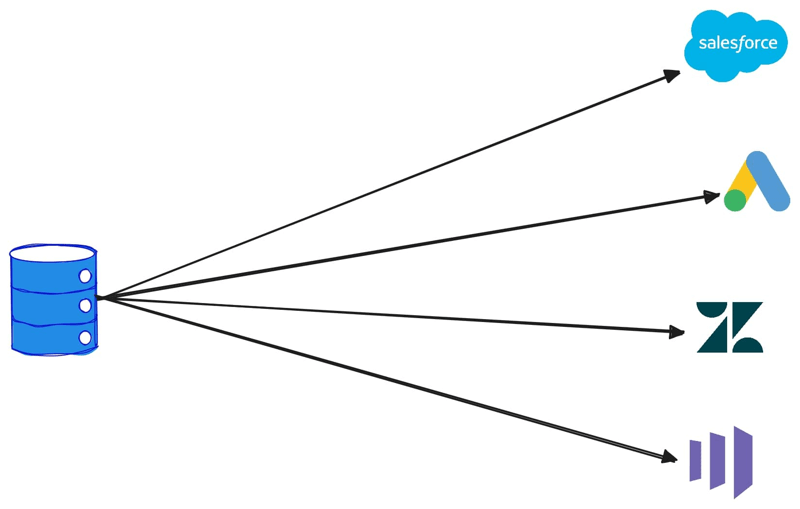
Este enfoque garantiza datos oportunos y consistentes en todas las herramientas operacionales, lo que permite una mejor alineación entre las aplicaciones de negocio. Reverse ETL funciona como una herramienta de sincronización, manteniendo la consistencia y entregando información actualizada en todo el conjunto de aplicaciones de una empresa. En efecto, transforma el data warehouse de una simple solución de almacenamiento en un hub crucial para el refinamiento continuo de datos y los insights estratégicos, permitiendo que los datos impulsen decisiones y acciones más informadas en toda la empresa.
Beneficios de Reverse ETL
- Activación de datos: permite que los equipos no técnicos aprovechen los datos guardados en el warehouse para la interacción con clientes y otras operaciones de negocio, aumentando de forma significativa el valor de los datos.
- Mayor eficiencia de ingeniería: Reverse ETL alivia la carga de los data engineers, que de otro modo estarían saturados construyendo y manteniendo conexiones de API a medida para marketing y otros equipos.
- Accesibilidad para equipos no técnicos: acelera el proceso de poner los datos del warehouse a disposición de los equipos de negocio, eliminando la necesidad de soporte continuo de ingeniería.
Desafíos de Reverse ETL
Los desafíos de Reverse ETL incluyen gestionar los rate limits de las APIs, garantizar la seguridad de los datos durante la transferencia y mantener la frescura de los datos en los sistemas operacionales. Estos desafíos requieren soluciones y estrategias sólidas para que los beneficios operacionales de Reverse ETL se logren sin comprometer la integridad de los datos ni el rendimiento.
Otro desafío crítico es el data governance, que se vuelve aún más importante cuando los datos analíticos vuelven a fluir hacia los sistemas operacionales. Alimentar con datos enriquecidos herramientas como CRMs o plataformas de marketing introduce nuevos requisitos de:
- Calidad de datos: los datos analíticos suelen provenir de múltiples sistemas con distintos grados de limpieza. Sin controles de calidad rigurosos, los errores o inconsistencias pueden propagarse a los flujos downstream, socavando la confianza en los datos.
- Control de acceso: las herramientas operacionales pueden exponer datos sensibles a una audiencia más amplia. Los permisos basados en roles y las estrategias de anonimización son esenciales para prevenir accesos no autorizados.
- Monitoreo: sincronizar datos entre sistemas a escala requiere monitoreo activo para detectar inconsistencias, errores o retrasos. Los frameworks de monitoreo sólidos aseguran que los flujos de datos sigan siendo confiables y cumplan con las normativas.
Sin abordar estos temas de governance, Reverse ETL corre el riesgo de crear nuevos silos, propagar inexactitudes o incluso generar problemas de cumplimiento.
Herramientas y tecnologías
Está surgiendo un ecosistema vibrante de soluciones de reverse ETL, con startups como Hightouch, Census, Grouparoo (open source), Polytomic, Rudderstack y Seekwell a la cabeza. Incluso plataformas como Workato están incorporando funcionalidades de reverse ETL con capacidades de sincronización diferencial.
Conclusión
Reverse ETL está pasando de ser una solución de nicho a un componente clave del modern data stack. Su potencial para desbloquear todas las capacidades de los data warehouses e integrarse sin fricciones con distintos sistemas de negocio está cambiando la forma en que interactuamos con los datos. A medida que este ecosistema sigue evolucionando, las posibilidades de reconfigurar las operaciones de datos y la analítica son enormes. Este enfoque se está convirtiendo rápidamente en un estándar del modern data stack, aprovechando los activos de datos existentes de formas sin precedentes.